2.1 样本均值的期望和方差
假设总体服从的分布期望为,方差为.
样本均值的期望和方差为
2.2 样本方差的期望
假设总体服从的分布期望为,方差为.
样本方差的期望为
这是关于 经验分布函数(empirical distribution function, EDF) 的定义。以下是主要内容的 Markdown 格式转换:
2.3 经验分布函数(empirical distribution function)的定义
定义 2.1
设 为总体 中抽取的 i.i.d. 样本,将其按大小排列为
对任意实数 ,定义如下函数:
$Fn(x) =
\begin{cases}
0, & x < X{(1)}, \
\frac{n}{k}, & X{(k)} \leq x < X{(k+1)}, \quad k = 1,2,\dots, n-1, \
1, & X_{(n)} \leq x
\end{cases}$
称 为 经验分布函数。
指示性函数
若记 指示性函数 为:
$I_A(x) =
\begin{cases}
1, & \text{当 } x \in A, \
0, & \text{其他}
\end{cases}$
则 可表示为
由定义可知 是仅依赖于样本 的函数,因此它是统计量。
易见经验分布函数是单调、非降、右连续函数,具有分布函数的基本性质。它在 , 处有间断,它是在每个间断点跳跃的幅度为 的阶梯函数。
若记 ,,则有 ,
,且 i.i.d. ,
故 ,因此有
2.4 经验分布函数的大样本性质
利用二项分布的性质可知 具有下列大样本性质:
渐近正态性:由中心极限定理,则当 时有
强收敛性:由 Borel 强大数定律,则在 时有
格里文科(Glivenko-Cantelli)定理:设 为分布函数 的经验分布函数,记
则有
2.5 次序统计量的分布
最大及最小次序统计量的分布:
最大次序统计量:
最小次序统计量:
定理 2.1
设总体 的密度函数为 ,分布函数为 , 是来自总体 的样本,则第 个次序统计量 的分布函数和密度函数分别为
注:
- 次序统计量 表示 中有 个变量小于等于 。
- 令 和 ,分别得到最小次序统计量和最大次序统计量的分布函数和密度函数。
证明
根据题意有第 次序统计量 的分布函数为
由此可知
根据积分函数求导完成证明。
恒等式的证明:
注意到当 时成立,因此只需证明两边求导相等,计算左边导数如下
其中第三个等式利用组合恒等式
进而左右导数相等,恒等式成立。
定理 2.2
设总体 有密度函数 ,,令 为从总体 中抽取的简单样本,如前所述 为样本 的次序统计量。
令 ,,则次序统计量 的联合密度为
- 定理的证明方法 是将样本变量和次序统计量之间作变换,导出变换后次序统计量的分布来实现的。
2.6 抽样分布: 分布
分布的定义和密度函数
在总体分布为正态情形,许多重要统计量的抽样分布可以求得,下面首先介绍 分布的定义和性质。
定义 2.2 设 i.i.d. ,则称
是自由度为 的 变量,其分布称为自由度为 的 分布,记为 。
定理 2.3
设随机变量 是自由度为 的 随机变量,则其概率密度函数为
其中 。显然, 分布的密度函数与 Gamma 分布 的密度函数相同。
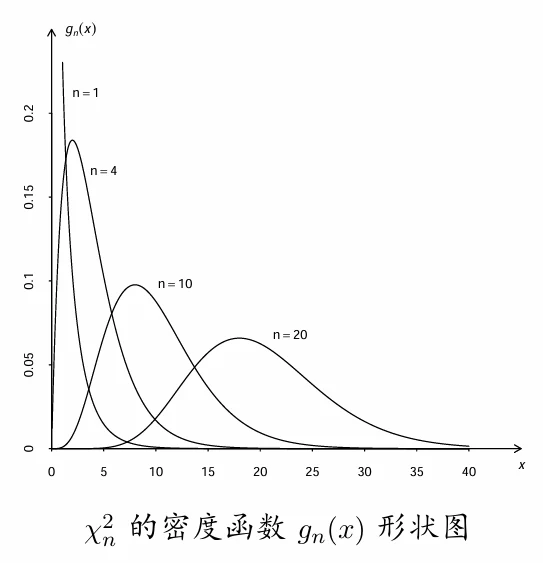
分布的密度函数的形状和分位数
密度函数的支撑集为 。
当自由度 越大, 的密度曲线越趋于对称(由中心极限定理知当 时,它趋于正态分布);
越小,曲线越不对称。当 时密度曲线是单调下降趋于 。当 时密度曲线有单峰,从 开始先单调上升,在一定位置达到峰值,然后再单调下降趋向于 。
令 ,则称 为 分布的上侧 分位数。如 等。当 和 给定时,可查附表 3 求出 之值,如 , 等。这在后面的区间估计和假设检验问题中常常用到。
定义 2.3 设 ,。且 和 独立,则称
是自由度为 的 变量,共有 份 分布,记为 。
- 变量的概率密度函数如下面的定理给出:
定理 2.4 设随机变量 ,则其概率密度为
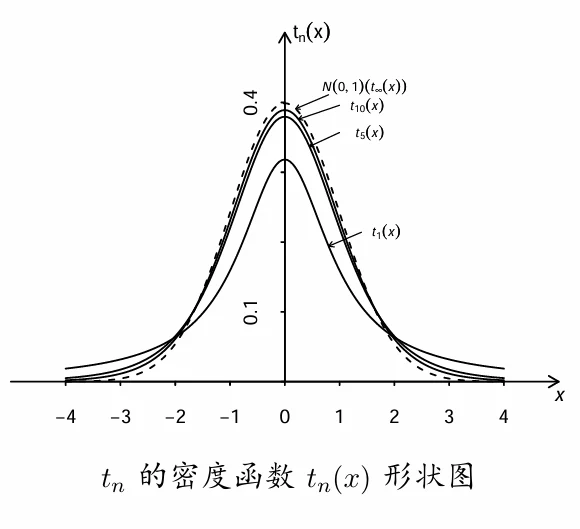
的密度函数与标准正态分布 密度相似,但它们是 关于原点对称的,单峰的概率密度,在 处达到极大值。 的峰 值低于 的峰值, 的密度函数是锥型比 的两侧 尾部粗一些,容易证明: 变量的极限分布为 。
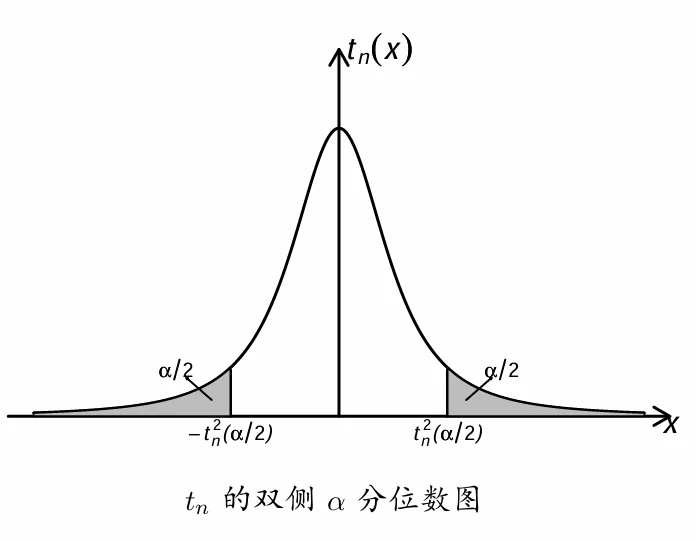
设 , 则称 为自 由度为 的 分布的双侧 分位数。当给定 和 时,可查附 表 2 求出 、 等。例如 , 等。这在后面的区间估计和假设检验问题中常 常用到。
设 r.v. , 则 只有当 时存在,且
特别当 时,。当 时,。
当 时 分布就是柯西分布,即
当 时, 变量的极限分布为 ,即
分布的定义及密度函数
定理 2.4 设 r.v. ,且 和 独立,则称
是自由度为 和 (注意分子的自由度在前)的 变量,其分布称为自由度为 和 的 分布,记为 。
变量的概率密度函数如下面的定理给出:
定理 2.5 设 r.v. ,则其概率密度函数为
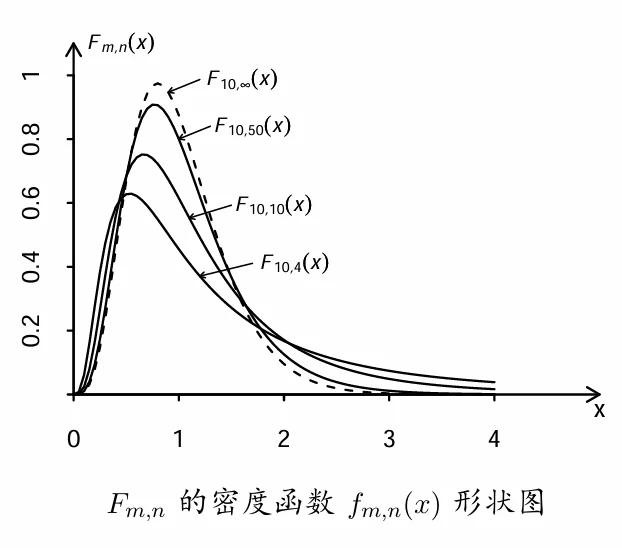
分布的自由度 和 是有限度的,当 时,若将自由度 和 的顺序颠倒一下,得到的并不是两个不同的 分布。 分布 的支持集为 。密度曲线是单峰、偏态的,密度曲线的形状 随自由度 的改变而变化。
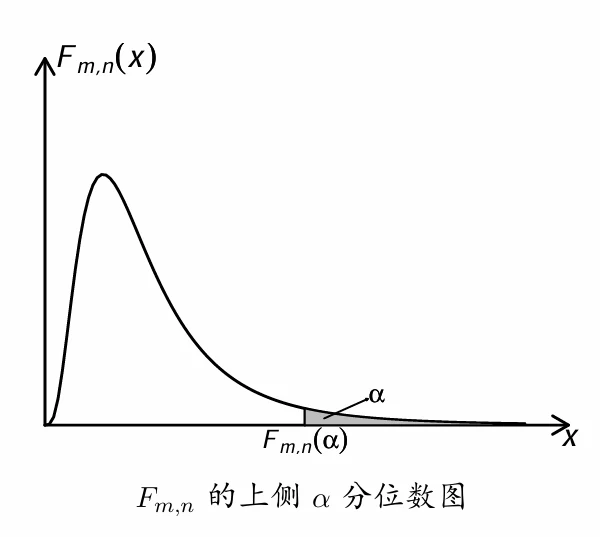
令 ,则称 为 分布的上侧 分位数。当 和 给定时,可以通过查附表 4 求出 之值。例如 , 等。这 在后面的区间估计和假设检验问题中常常用到。
设 ,则 。
设 ,则对 且 时有
特别
设 ,则 。
。此性质在区间估计和假设检验问题中 常常用到。
一个习题:
设独立,定义
其中
求的分布.
解答
设总体 ( X \sim N(0, 1) ),给定一组样本观察值:
( X1 = 0, \, X_2 = 0.2, \, X_3 = 0.25, \, X_4 = -0.3, \, X_5 = -0.1, \, X_6 = 2, \, X_7 = 0.15, \, X_8 = 1, \, X_9 = -0.7, \, X{10} = -1 )。
我们需要解决以下三个问题:
- 求上述样本的经验分布函数;
- 计算 ( E[F(X{(6)})] ) 和 ( D[F(X{(6)})] ),其中 ( X_{(6)} ) 为容量为 10 的次序统计量;
- 计算容量 ( n = 10 ) 的样本中次序统计量 ( X_{(6)} ) 的分布函数在 0.2 处的值。
(1) 求上述样本的经验分布函数
经验分布函数 ( Fn(x) ) 是对总体分布函数的非参数估计,定义为:
[ F_n(x) = \frac{1}{n} \sum{i=1}^n I(X_i \leq x) ]
其中 ( n ) 是样本容量,( I(X_i \leq x) ) 是指示函数,当 ( X_i \leq x ) 时取 1,否则取 0。
步骤:
- 样本容量 ( n = 10 )。
- 将样本数据按升序排列:
( -1, -0.7, -0.3, -0.1, 0, 0.15, 0.2, 0.25, 1, 2 ) - 根据定义,( F_n(x) ) 在每个样本点处跳跃,跳跃幅度为 ( \frac{1}{10} = 0.1 )。
结果:
经验分布函数 ( F_n(x) ) 为:
[ F_n(x) = \begin{cases}
0 & \text{if } x < -1 \
0.1 & \text{if } -1 \leq x < -0.7 \
0.2 & \text{if } -0.7 \leq x < -0.3 \
0.3 & \text{if } -0.3 \leq x < -0.1 \
0.4 & \text{if } -0.1 \leq x < 0 \
0.5 & \text{if } 0 \leq x < 0.15 \
0.6 & \text{if } 0.15 \leq x < 0.2 \
0.7 & \text{if } 0.2 \leq x < 0.25 \
0.8 & \text{if } 0.25 \leq x < 1 \
0.9 & \text{if } 1 \leq x < 2 \
1 & \text{if } x \geq 2
\end{cases} ]
这是一个右连续的阶梯函数,在每个样本点处增加 ( 0.1 )。
(2) 计算 ( E[F(X{(6)})] ) 和 ( D[F(X{(6)})] )
定义:
- ( X_{(6)} ) 是样本中第 6 个次序统计量(即第 6 小值)。
- ( F(x) = \Phi(x) ) 是标准正态分布 ( N(0, 1) ) 的累积分布函数(CDF)。
- 我们需要计算 ( E[\Phi(X{(6)})] )(期望)和 ( D[\Phi(X{(6)})] )(方差)。
理论依据:
- 对于来自任何连续分布的独立同分布样本,( F(X_{(k)}) ) 服从贝塔分布 (\text{Beta}(k, n - k + 1))。
- 这里 ( X \sim N(0, 1) ),所以 ( \Phi(X_i) \sim U(0, 1) )(均匀分布)。
- 对于次序统计量,( \Phi(X_{(6)}) \sim \text{Beta}(6, 10 - 6 + 1) = \text{Beta}(6, 5) )。
贝塔分布的性质:
- 若 ( Y \sim \text{Beta}(\alpha, \beta) ),则:
- 期望:( E[Y] = \frac{\alpha}{\alpha + \beta} )
- 方差:( \text{Var}[Y] = \frac{\alpha \beta}{(\alpha + \beta)^2 (\alpha + \beta + 1)} )
- 代入 ( \alpha = 6 ),( \beta = 5 ):
- ( E[\Phi(X_{(6)})] = \frac{6}{6 + 5} = \frac{6}{11} )
- ( \text{Var}[\Phi(X_{(6)})] = \frac{6 \times 5}{(6 + 5)^2 (6 + 5 + 1)} = \frac{30}{11^2 \times 12} = \frac{30}{121 \times 12} = \frac{30}{1452} = \frac{5}{242} )
结果:
- ( E[F(X_{(6)})] = \frac{6}{11} )
- ( D[F(X_{(6)})] = \frac{5}{242} )
(3) 计算次序统计量 ( X_{(6)} ) 的分布函数在 0.2 处的值
目标:
计算 ( P(X_{(6)} \leq 0.2) ),即第 6 个次序统计量的分布函数在 ( x = 0.2 ) 处的值。
公式:
对于来自连续分布 ( F(x) ) 的样本,次序统计量 ( X{(k)} ) 的分布函数为:
[ F{X{(k)}}(x) = P(X{(k)} \leq x) = \sum_{j=k}^{n} \binom{n}{j} [F(x)]^j [1 - F(x)]^{n - j} ]
- 这里 ( n = 10 ),( k = 6 ),( x = 0.2 ),( F(x) = \Phi(0.2) )。
- ( \Phi(0.2) ) 是标准正态分布的 CDF 值,近似为 ( \Phi(0.2) \approx 0.5793 )(可通过标准正态表查得)。
计算:
[ P(X{(6)} \leq 0.2) = \sum{j=6}^{10} \binom{10}{j} (0.5793)^j (1 - 0.5793)^{10 - j} = \sum_{j=6}^{10} \binom{10}{j} (0.5793)^j (0.4207)^{10 - j} ]
逐项计算:
- ( j = 6 ):
( \binom{10}{6} = 210 )
( (0.5793)^6 \approx 0.0378 ),( (0.4207)^4 \approx 0.0313 )
( 210 \times 0.0378 \times 0.0313 \approx 0.2478 ) - ( j = 7 ):
( \binom{10}{7} = 120 )
( (0.5793)^7 \approx 0.0219 ),( (0.4207)^3 \approx 0.0743 )
( 120 \times 0.0219 \times 0.0743 \approx 0.1956 ) - ( j = 8 ):
( \binom{10}{8} = 45 )
( (0.5793)^8 \approx 0.0127 ),( (0.4207)^2 \approx 0.1770 )
( 45 \times 0.0127 \times 0.1770 \approx 0.1013 ) - ( j = 9 ):
( \binom{10}{9} = 10 )
( (0.5793)^9 \approx 0.0074 ),( (0.4207)^1 = 0.4207 )
( 10 \times 0.0074 \times 0.4207 \approx 0.0311 ) - ( j = 10 ):
( \binom{10}{10} = 1 )
( (0.5793)^{10} \approx 0.0043 ),( (0.4207)^0 = 1 )
( 1 \times 0.0043 \times 1 = 0.0043 )
总和:
[ P(X_{(6)} \leq 0.2) \approx 0.2478 + 0.1956 + 0.1013 + 0.0311 + 0.0043 = 0.5801 ]
结果:
( P(X_{(6)} \leq 0.2) \approx 0.5801 )
(注:结果保留四位小数,精确值可能因 ( \Phi(0.2) ) 的精度而略有变化。)
总结
经验分布函数 ( F_n(x) ):
一个阶梯函数,在样本点 ( -1, -0.7, -0.3, -0.1, 0, 0.15, 0.2, 0.25, 1, 2 ) 处分别跳跃 ( 0.1 )。期望和方差:
- ( E[F(X_{(6)})] = \frac{6}{11} )
- ( D[F(X_{(6)})] = \frac{5}{242} )
分布函数值:
( P(X_{(6)} \leq 0.2) \approx 0.5801 )